U-Net:用于生物医学图像分割的卷积网络
原文信息
Olaf Ronneberger, Philipp Fischer, Thomas Brox. U-Net: Convolutional Networks for Biomedical Image Segmentation. arXiv:1505.04597v1 [cs.CV], 2015.
单位:德国弗赖堡大学计算机科学系、BIOSS 生物信号研究中心。
以下为论文全文的中文翻译。章节、公式、图、表和参考文献编号均与原文一致;图内英文标注与参考文献保留原文。
摘要
人们普遍认为,成功训练深度网络需要数千个带标注的训练样本。本文提出一种网络与训练策略,它强烈依赖数据增强,从而更高效地利用可用的标注样本。该架构由一条用于捕获上下文的收缩路径和一条对称的、能够实现精确定位的扩张路径组成。我们表明,这样的网络可以从极少量图像端到端训练,并在 ISBI 电子显微镜图像堆栈中神经元结构分割挑战赛上优于此前的最佳方法(滑动窗口卷积网络)。使用在透射光显微图像(相差和 DIC)上训练的同一网络,我们在 2015 年 ISBI 细胞追踪挑战赛的这些类别中以较大优势获胜。此外,该网络速度很快:在当时的 GPU 上,分割一幅 512×512 图像耗时不到一秒。完整实现(基于 Caffe)与训练好的网络可在 http://lmb.informatik.uni-freiburg.de/people/ronneber/u-net 获取。
1 引言
过去两年,深度卷积网络在许多视觉识别任务中超越了此前的最佳水平,例如 [7,3]。卷积网络本身早已存在 [8],但其成功受限于可用训练集的规模以及所考虑网络的规模。Krizhevsky 等人 [7] 的突破来自在包含 100 万幅训练图像的 ImageNet 数据集上,对一个具有 8 层和数百万参数的大网络进行监督训练。此后,人们训练了更大、更深的网络 [12]。
卷积网络的典型用途是分类任务,即对一幅图像输出单个类别标签。然而,在许多视觉任务中,尤其是生物医学图像处理中,期望的输出应包含定位,也就是要为每个像素分配一个类别标签。此外,在生物医学任务中,数千幅训练图像通常难以获得。因此,Ciresan 等人 [1] 以滑动窗口方式训练网络,通过提供每个像素周围的局部区域(图像块)作为输入,来预测该像素的类别标签。首先,这种网络能够定位;其次,以图像块形式提供的训练数据远多于训练图像的数量。由此得到的网络在 ISBI 2012 的 EM 分割挑战赛中以较大优势获胜。
显然,Ciresan 等人 [1] 的策略有两个缺点。第一,它相当慢,因为网络必须对每个图像块单独运行,而且重叠的图像块带来了大量冗余。第二,定位精度与上下文利用之间存在权衡:较大的图像块需要更多最大池化层,从而降低定位精度;而较小的图像块只允许网络看到很少的上下文。较新的方法 [11,4] 提出一种分类器输出,它同时考虑来自多个层的特征,从而可以兼顾良好的定位与上下文的利用。
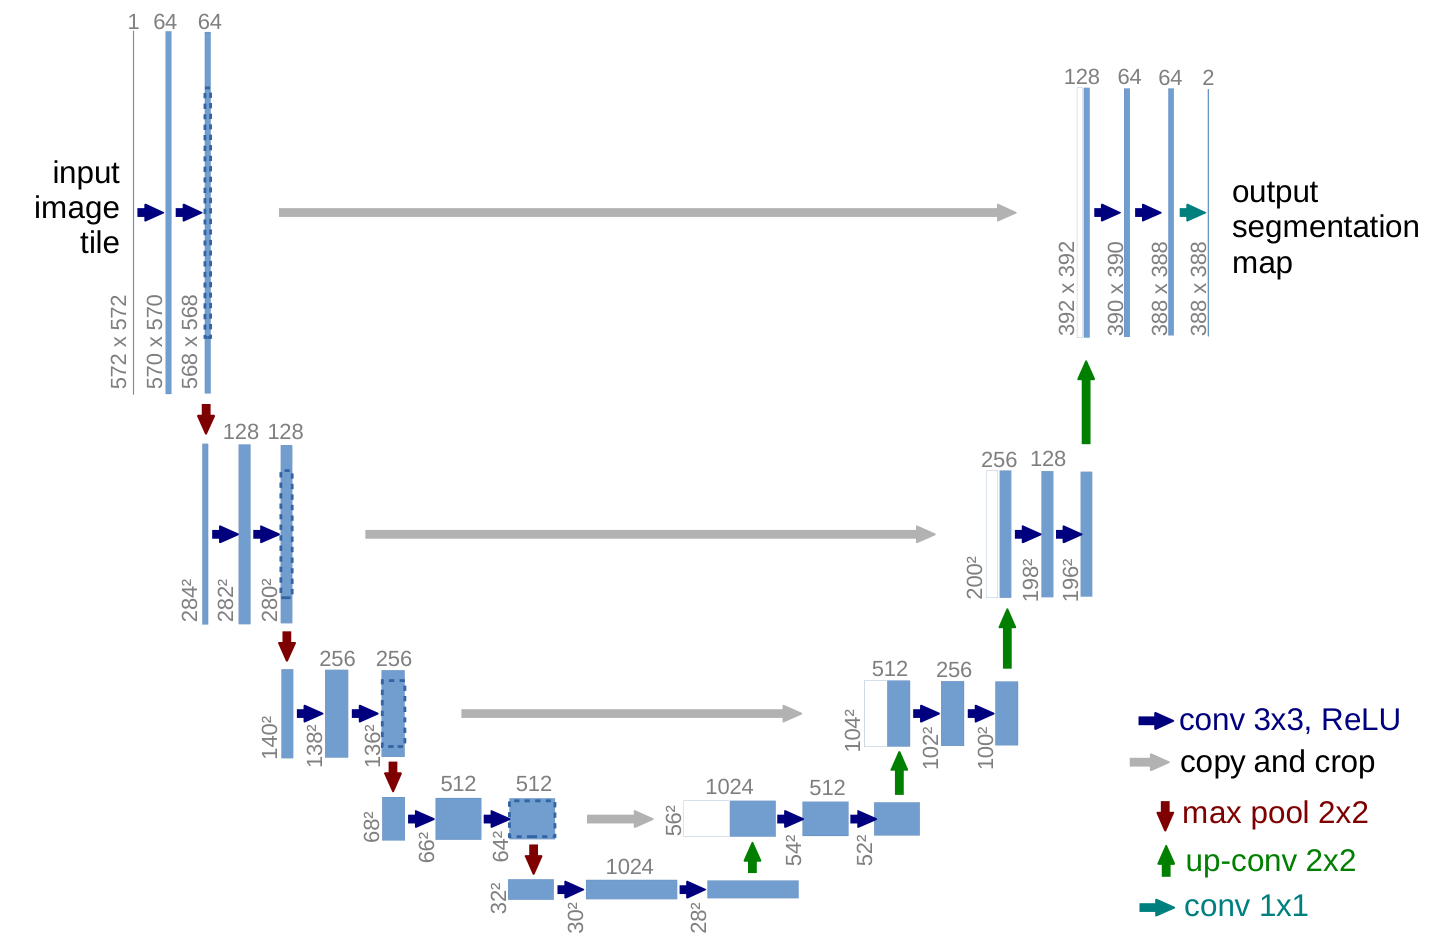
图 1. U-Net 架构(以最低分辨率为 32×32 像素为例)。每个蓝色框对应一个多通道特征图,通道数标在框的上方,x-y 尺寸标在框的左下角。白色框表示复制得到的特征图,箭头表示不同操作。
本文基于一种更优雅的架构,即所谓的“全卷积网络”[9]。我们修改并扩展该架构,使其在训练图像极少的情况下仍能工作,并产生更精确的分割结果;见图 1。文献 [9] 的主要思想是在常规收缩网络中补充逐层结构,将池化算子替换为上采样算子。因此,这些层提高了输出的分辨率。为了实现定位,来自收缩路径的高分辨率特征与上采样后的输出相结合。随后的卷积层便可基于这些信息学习组合出更精确的输出。
我们架构中的一项重要修改是,在上采样部分同样使用大量特征通道,使网络能够将上下文信息传播到更高分辨率的层。因此,扩张路径与收缩路径大致对称,形成 U 形架构。该网络没有任何全连接层,并且只使用每次卷积的有效部分,即分割图只包含那些在输入图像中可获得完整上下文的像素。这一策略允许通过重叠切块策略对任意大的图像进行无缝分割(见图 2)。为了预测图像边界区域的像素,缺失的上下文通过对输入图像进行镜像来外推。这种切块策略对于将网络应用于大图像非常重要,否则分辨率将受限于 GPU 显存。
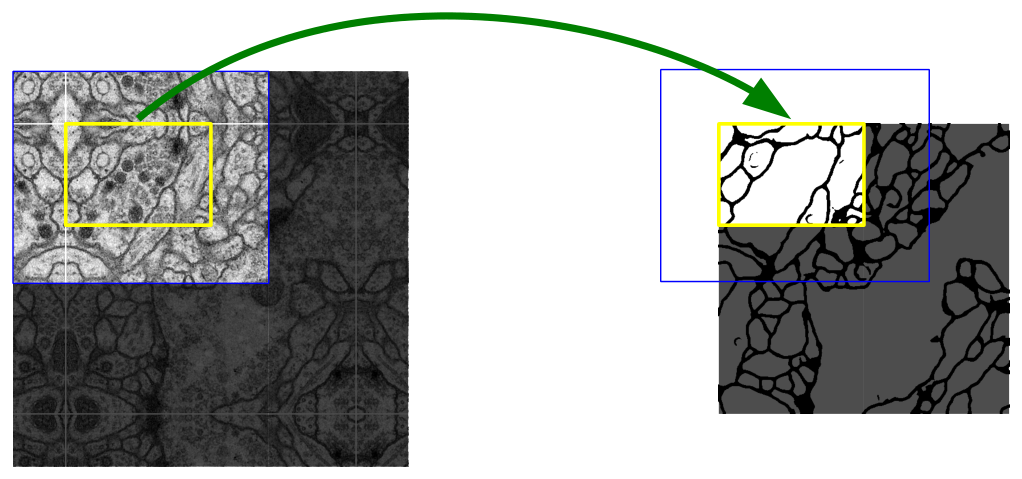
图 2. 用于无缝分割任意大图像的重叠切块策略(此处为 EM 堆栈中神经元结构的分割)。要预测黄色区域的分割结果,需要蓝色区域内的图像数据作为输入;缺失的输入数据通过镜像进行外推。
由于我们的任务可用的训练数据很少,我们对现有训练图像施加弹性变形,以进行大量数据增强。这使网络能够学习对此类变形的不变性,而无需在标注图像集中见到这些变换。这一点在生物医学分割中尤为重要,因为变形曾是组织中最常见的变化,而真实感变形可以被高效地模拟。数据增强对学习不变性的价值已在 Dosovitskiy 等人 [2] 的无监督特征学习工作中得到展示。
许多细胞分割任务中的另一个挑战是分离同类别的相互接触物体,见图 3。为此,我们提出使用加权损失,让相互接触细胞之间的分离背景标签在损失函数中获得较大的权重。
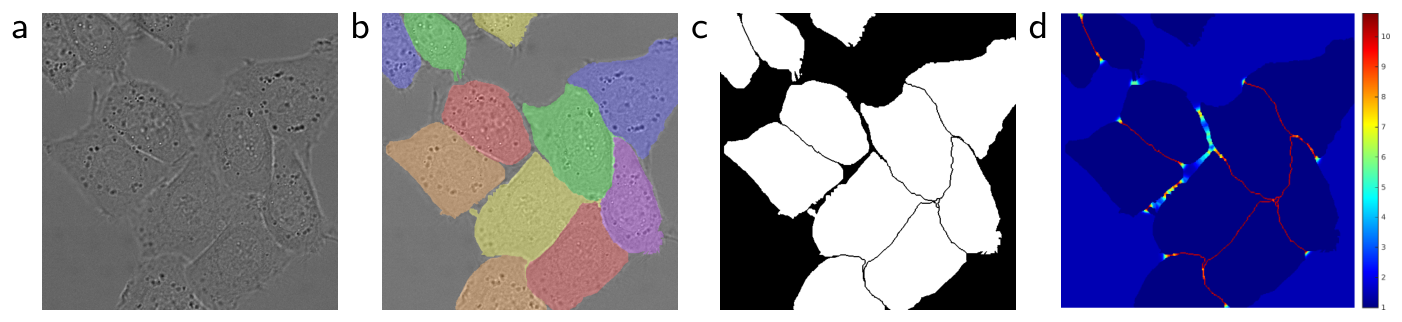
图 3. 用 DIC(微分干涉相差)显微镜记录的玻璃上的 HeLa 细胞。(a) 原始图像;(b) 叠加真值分割,不同颜色表示 HeLa 细胞的不同实例;(c) 生成的分割掩膜(白色:前景,黑色:背景);(d) 逐像素损失权重图,用于迫使网络学习边界像素。
所得网络适用于多种生物医学分割问题。本文展示了在 EM 堆栈中神经元结构分割上的结果(该竞赛始于 ISBI 2012,目前仍在进行),我们在此优于 Ciresan 等人 [1] 的网络。此外,我们还展示了 ISBI 细胞追踪挑战赛 2015 中光学显微图像细胞分割的结果。在该赛事两个最具挑战性的二维透射光数据集上,我们以较大优势获胜。
2 网络架构
网络架构如图 1 所示,由一条收缩路径(左侧)和一条扩张路径(右侧)组成。收缩路径遵循卷积网络的典型架构:重复应用两个 3×3 卷积(无填充卷积),每个卷积后接一个修正线性单元(ReLU),再接一个步长为 2 的 2×2 最大池化进行下采样。在每一次下采样步骤中,我们将特征通道数加倍。扩张路径中的每一步包括:对特征图进行上采样,随后进行一个 2×2 卷积(“上卷积”),使特征通道数减半;与来自收缩路径的相应裁剪特征图进行拼接;再进行两个 3×3 卷积,每个卷积后接一个 ReLU。由于每次卷积都会损失边界像素,因此需要裁剪。在最后一层,使用 1×1 卷积将每个 64 维特征向量映射到所需类别数。整个网络共有 23 个卷积层。
为了实现输出分割图的无缝拼接(见图 2),必须选择这样的输入块尺寸:使所有 2×2 最大池化操作都作用于 x、y 尺寸为偶数的层。
3 训练
输入图像及其对应的分割图用于训练网络,采用 Caffe [6] 的随机梯度下降实现。由于使用无填充卷积,输出图像比输入图像小一个固定的边界宽度。为最小化开销并最大限度利用 GPU 显存,我们倾向于使用较大的输入块而不是较大的批大小,因此将批大小减为单幅图像。相应地,我们采用较高的动量(0.99),使大量先前见过的训练样本决定当前优化步骤中的更新。
能量函数由最终特征图上的逐像素 soft-max 与交叉熵损失函数组合计算。soft-max 定义为 \(p_k(\mathbf{x})=\exp(a_k(\mathbf{x}))\big/\left(\sum_{k'=1}^{K}\exp(a_{k'}(\mathbf{x}))\right)\),其中 \(a_k(\mathbf{x})\) 表示像素位置 \(\mathbf{x}\in\Omega\) 处特征通道 \(k\) 的激活值,且 \(\Omega\subset\mathbb{Z}^2\)。\(K\) 为类别数,\(p_k(\mathbf{x})\) 是近似最大值函数。也就是说,对于使激活 \(a_k(\mathbf{x})\) 最大的 \(k\),\(p_k(\mathbf{x})\approx1\);对于其他所有 \(k\),\(p_k(\mathbf{x})\approx0\)。交叉熵则在每个位置惩罚 \(p_{\ell(\mathbf{x})}(\mathbf{x})\) 与 1 的偏差:
\[ E=\sum_{\mathbf{x}\in\Omega}w(\mathbf{x})\log\left(p_{\ell(\mathbf{x})}(\mathbf{x})\right), \tag{1} \]其中 \(\ell:\Omega\to\{1,\ldots,K\}\) 是每个像素的真实标签,\(w:\Omega\to\mathbb{R}\) 是我们引入的权重图,用于在训练中赋予某些像素更高的重要性。
我们为每幅真值分割图预先计算权重图,以补偿训练数据集中某一类别像素出现频率的差异,并迫使网络学习我们在相互接触细胞之间引入的狭窄分离边界(见图 3c 和 d)。
分离边界通过形态学操作计算。随后按下式计算权重图:
\[ w(\mathbf{x})=w_c(\mathbf{x})+w_0\cdot\exp\left(-\frac{(d_1(\mathbf{x})+d_2(\mathbf{x}))^2}{2\sigma^2}\right), \tag{2} \]其中 \(w_c:\Omega\to\mathbb{R}\) 是用于平衡类别频率的权重图,\(d_1:\Omega\to\mathbb{R}\) 表示到最近细胞边界的距离,\(d_2:\Omega\to\mathbb{R}\) 表示到第二近细胞边界的距离。在我们的实验中,取 \(w_0=10\),\(\sigma\approx5\) 像素。
在具有许多卷积层和不同通路的深度网络中,权重的良好初始化极其重要。否则,网络的一部分可能产生过大的激活值,而另一部分则从不参与贡献。理想情况下,初始权重应使网络中每个特征图具有近似单位方差。对于采用我们这种架构(卷积层与 ReLU 层交替)的网络,可以从标准差为 \(\sqrt{2/N}\) 的高斯分布中抽取初始权重来实现这一点,其中 \(N\) 表示一个神经元的输入节点数 [5]。例如,对于 3×3 卷积且前一层有 64 个特征通道的情况,\(N=9\cdot64=576\)。
3.1 数据增强
当只有少量训练样本时,数据增强对于教会网络所需的不变性与鲁棒性至关重要。对于显微图像,我们主要需要平移和旋转不变性,以及对变形和灰度变化的鲁棒性。特别是训练样本的随机弹性变形,似乎是用极少量标注图像训练分割网络的关键。我们使用 3×3 粗网格上的随机位移向量生成平滑变形。位移从标准差为 10 像素的高斯分布中采样,然后通过双三次插值计算逐像素位移。收缩路径末端的 Drop-out 层进一步执行隐式数据增强。
4 实验
我们展示了 U-Net 在三个不同分割任务中的应用。第一个任务是电子显微记录中神经元结构的分割。数据集示例及我们得到的分割结果如图 2 所示,完整结果作为补充材料提供。该数据集由 EM 分割挑战赛 [14] 提供,该挑战赛始于 ISBI 2012,目前仍接受新的投稿。训练数据是一组 30 幅图像(512×512 像素),来自果蝇一龄幼虫腹神经索(VNC)的连续切片透射电子显微镜。每幅图像都配有对应的、完整标注的细胞(白色)与膜(黑色)真值分割图。测试集公开可用,但其分割图保密。将预测的膜概率图发送给组织者即可获得评估结果。评估方法是在 10 个不同阈值下对概率图进行阈值化,并计算“形变误差(warping error)”“Rand 误差”和“像素误差”[14]。
U-Net(对输入数据的 7 个旋转版本取平均)在没有任何进一步预处理或后处理的情况下,取得了 0.0003529 的形变误差(新的最佳成绩,见表 1)和 0.0382 的 Rand 误差。
这显著优于 Ciresan 等人 [1] 的滑动窗口卷积网络结果,其最佳提交的形变误差为 0.000420,Rand 误差为 0.0504。就 Rand 误差而言,该数据集上唯一表现更好的算法,是对 Ciresan 等人 [1] 的概率图采用高度针对该数据集的后处理方法1。
表 1. EM 分割挑战赛 [14] 的排名(2015 年 3 月 6 日),按形变误差排序。
| 排名 | 团队名称 | 形变误差 | Rand 误差 | 像素误差 |
|---|---|---|---|---|
| ** 人类取值 ** | 0.000005 | 0.0021 | 0.0010 | |
| 1. | u-net | 0.000353 | 0.0382 | 0.0611 |
| 2. | DIVE-SCI | 0.000355 | 0.0305 | 0.0584 |
| 3. | IDSIA [1] | 0.000420 | 0.0504 | 0.0613 |
| 4. | DIVE | 0.000430 | 0.0545 | 0.0582 |
| ⋮ | ||||
| 10. | IDSIA-SCI | 0.000653 | 0.0189 | 0.1027 |
我们还把 U-Net 应用于光学显微图像中的细胞分割任务。该分割任务是 ISBI 细胞追踪挑战赛 2014 和 2015 的一部分 [10,13]。第一个数据集“PhC-U373”2 包含在聚丙烯酰胺基底上、由相差显微镜记录的胶质母细胞瘤-星形细胞瘤 U373 细胞(见图 4a、b 及补充材料)。它包含 35 幅部分标注的训练图像。我们在此取得了 92% 的平均 IOU(“交并比”),显著优于第二好算法的 83%(见表 2)。第二个数据集“DIC-HeLa”3 是平坦玻璃上、由微分干涉相差(DIC)显微镜记录的 HeLa 细胞(见图 3、图 4c、d 及补充材料)。它包含 20 幅部分标注的训练图像。我们在此取得了 77.5% 的平均 IOU,显著优于第二好算法的 46%。
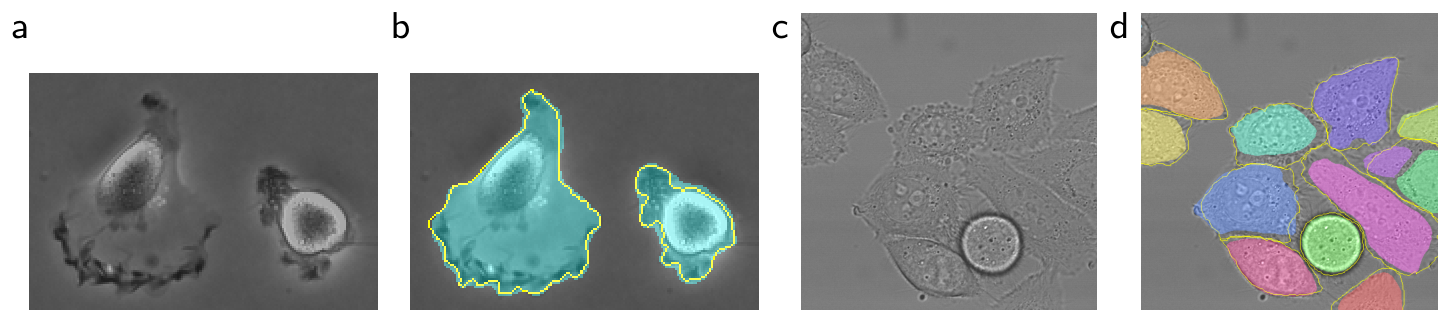
图 4. ISBI 细胞追踪挑战赛上的结果。(a) “PhC-U373”数据集的一幅输入图像的一部分;(b) 分割结果(青色掩膜)与人工真值(黄色边界);(c) “DIC-HeLa”数据集的一幅输入图像;(d) 分割结果(随机着色掩码)与人工真值(黄色边界)。
表 2. ISBI 细胞追踪挑战赛 2015 的分割结果(IOU)。
| 名称 | PhC-U373 | DIC-HeLa |
|---|---|---|
| IMCB-SG (2014) | 0.2669 | 0.2935 |
| KTH-SE (2014) | 0.7953 | 0.4607 |
| HOUS-US (2014) | 0.5323 | - |
| second-best 2015 | 0.83 | 0.46 |
| u-net (2015) | 0.9203 | 0.7756 |
5 结论
U-Net 架构在非常不同的生物医学分割应用中取得了很好的性能。得益于弹性变形的数据增强,它只需要极少量标注图像,训练时间也相当合理:在 NVIDIA Titan GPU(6 GB)上仅需 10 小时。我们提供了完整的基于 Caffe [6] 的实现和训练好的网络4。我们相信,U-Net 架构可以轻松应用于更多任务。
致谢
本项研究得到德国联邦与州政府卓越计划(EXC 294)以及 BMBF(Fkz 0316185B)的支持。
脚注
- 该算法的作者提交了 78 个不同方案才取得这一结果。
- 数据集由美国加州大学伯克利分校生物工程系 Sanjay Kumar 博士提供。
- 数据集由荷兰鹿特丹伊拉斯姆斯医学中心 Gert van Cappellen 博士提供。
- U-Net 实现、训练好的网络与补充材料见 http://lmb.informatik.uni-freiburg.de/people/ronneber/u-net
参考文献
- Ciresan, D.C., Gambardella, L.M., Giusti, A., Schmidhuber, J.: Deep neural networks segment neuronal membranes in electron microscopy images. In: NIPS. pp. 2852–2860 (2012)
- Dosovitskiy, A., Springenberg, J.T., Riedmiller, M., Brox, T.: Discriminative unsupervised feature learning with convolutional neural networks. In: NIPS (2014)
- Girshick, R., Donahue, J., Darrell, T., Malik, J.: Rich feature hierarchies for accurate object detection and semantic segmentation. In: Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR) (2014)
- Hariharan, B., Arbelez, P., Girshick, R., Malik, J.: Hypercolumns for object segmentation and fine-grained localization (2014), arXiv:1411.5752 [cs.CV]
- He, K., Zhang, X., Ren, S., Sun, J.: Delving deep into rectifiers: Surpassing human-level performance on imagenet classification (2015), arXiv:1502.01852 [cs.CV]
- Jia, Y., Shelhamer, E., Donahue, J., Karayev, S., Long, J., Girshick, R., Guadarrama, S., Darrell, T.: Caffe: Convolutional architecture for fast feature embedding (2014), arXiv:1408.5093 [cs.CV]
- Krizhevsky, A., Sutskever, I., Hinton, G.E.: Imagenet classification with deep convolutional neural networks. In: NIPS. pp. 1106–1114 (2012)
- LeCun, Y., Boser, B., Denker, J.S., Henderson, D., Howard, R.E., Hubbard, W., Jackel, L.D.: Backpropagation applied to handwritten zip code recognition. Neural Computation 1(4), 541–551 (1989)
- Long, J., Shelhamer, E., Darrell, T.: Fully convolutional networks for semantic segmentation (2014), arXiv:1411.4038 [cs.CV]
- Maska, M., (…), de Solorzano, C.O.: A benchmark for comparison of cell tracking algorithms. Bioinformatics 30, 1609–1617 (2014)
- Seyedhosseini, M., Sajjadi, M., Tasdizen, T.: Image segmentation with cascaded hierarchical models and logistic disjunctive normal networks. In: Computer Vision (ICCV), 2013 IEEE International Conference on. pp. 2168–2175 (2013)
- Simonyan, K., Zisserman, A.: Very deep convolutional networks for large-scale image recognition (2014), arXiv:1409.1556 [cs.CV]
- WWW: Web page of the cell tracking challenge, http://www.codesolorzano.com/celltrackingchallenge/Cell_Tracking_Challenge/Welcome.html
- WWW: Web page of the em segmentation challenge, http://brainiac2.mit.edu/isbi_challenge/